Retour à la leçon·Leçon 7 sur 8·Produire une réponse
Des données ordonnées au tableau d'indicateurs
Le même diaporama que les téléchargements, rendu sous forme de page. Lancez le diaporama pour le présenter en plein écran — les flèches ou un clic avancent d'une diapositive, Échap quitte.
Ce que couvre cette leçon
- Un indicateur est un numérateur rapporté à un dénominateur, désagrégé
- La fiche de référence d'indicateur
- Construisez le numérateur comme une colonne
- Le tableau d'indicateurs
- La désagrégation
- Énoncez votre degré d'incertitude
- Mettez-le en forme pour le rapport
- La suite
Notes du présentateur
Transformer un jeu de données propre en tableau d'indicateurs désagrégé conforme au cadre logique, avec numérateur, dénominateur et intervalle de confiance explicitement énoncés.Un indicateur est un numérateur rapporté à un dénominateur, désagrégé
- Cette phrase résume toute la leçon.
Notes du présentateur
Cette phrase résume toute la leçon. La plupart des désaccords de rapportage sont en réalité des désaccords sur le dénominateur, et la plupart des autres portent sur les lignes qui appartiennent au numérateur. Donc, avant tout code : écrivez la définition.La fiche de référence d'indicateur
Champ Pour notre exemple Indicateur Prévalence de la malnutrition aiguë globale (MAG) par PB Numérateur Enfants de 6 à 59 mois dépistés avec un PB inférieur à 125 mm, ou porteurs d'œdèmes bilatéraux prenant le godet Dénominateur Enfants de 6 à 59 mois disposant d'une mesure de PB valide ou d'une évaluation des œdèmes consignée Désagrégation Commune, sexe, tranche d'âge (6-23, 24-59 mois) Fréquence Trimestrielle, et annuelle pour le rapport bailleur Source Registre de dépistage de masse communautaire, CommCare Décision éclairée Quelles communes reçoivent un site PCIMA supplémentaire au trimestre suivant Valeur de référence Une MAG égale ou supérieure à 15 % constitue le seuil d'urgence Notes du présentateur
Pour chaque indicateur que vous rapportez, remplissez ceci. Cela prend cinq minutes et met fin au débat avant qu'il ne commence.La fiche de référence d'indicateur
Si vous ne savez pas énoncer le dénominateur en une phrase, vous n'avez pas encore d'indicateur. Vous avez une colonne dont vous vous apprêtez à prendre la moyenne.
Notes du présentateur
Notez ce que le dénominateur n'est pas. Ce n'est pas l'ensemble des enfants de la commune — ce serait une prévalence ajustée sur la couverture, qui exige un chiffre de population dont ce registre ne dispose pas. Ce n'est pas non plus l'ensemble des lignes du fichier — cela inclurait des lignes sans aucune mesure. Être explicite là-dessus est ce qui empêche le chiffre d'être discrètement redéfini d'un rapport à l'autre.Construisez le numérateur comme une colonne — En Python (suite)
import numpy as np

MAS_MM = 115
MAG_MM = 125

muac["evalue"] = muac["muac_mm"].notna() | muac["oedema"].notna()

muac["mas"] = np.where(
    ~muac["evalue"],
    np.nan,
    ((muac["muac_mm"] < MAS_MM) | (muac["oedema"] == True)).astype(float),
)

muac["mag"] = np.where(
    ~muac["evalue"],
    np.nan,
Notes du présentateur
Ne filtrez pas. Créez un indicateur binaire, conservez toutes les lignes, et laissez l'agrégation faire le travail — le dénominateur reste ainsi visible dans le même tableau que le numérateur.Construisez le numérateur comme une colonne — En Python (suite)
((muac["muac_mm"] < MAG_MM) | (muac["oedema"] == True)).astype(float), )Construisez le numérateur comme une colonne — En R
MAS_MM <- 115 MAG_MM <- 125 muac <- muac |> mutate( evalue = !is.na(muac_mm) | !is.na(oedema), mas = if_else(evalue, (muac_mm < MAS_MM) | oedema %in% TRUE, NA), mag = if_else(evalue, (muac_mm < MAG_MM) | oedema %in% TRUE, NA) )Construisez le numérateur comme une colonne
- Les œdèmes signent une MAS indépendamment de la mesure. Un enfant à 130 mm porteur d'œdèmes bilatéraux prenant le…
oedema == Trueplutôt qu'un test de véracité. Un œdème manquant n'est pas un œdème absent. En R, `oedema %in%…
Notes du présentateur
Deux détails faciles à manquer et coûteux à négliger :Le tableau d'indicateurs — En Python (suite)
def tableau_indicateurs(df, par): groupes = df.groupby(par, dropna=False) tableau = groupes.agg( depistes=("child_id", "size"), denominateur=("evalue", "sum"), cas_mas=("mas", "sum"), cas_mag=("mag", "sum"), ) tableau["taux_mag"] = tableau["cas_mag"] / tableau["denominateur"] tableau["taux_mas"] = tableau["cas_mas"] / tableau["denominateur"] return tableau.reset_index() par_commune = tableau_indicateurs(muac, "commune").sort_values( "taux_mag", ascending=False )Le tableau d'indicateurs — En R (suite)
tableau_indicateurs <- function(df, par) { df |> group_by(across(all_of(par))) |> summarise( depistes = n(), denominateur = sum(evalue), cas_mas = sum(mas, na.rm = TRUE), cas_mag = sum(mag, na.rm = TRUE), .groups = "drop" ) |> mutate( taux_mag = cas_mag / denominateur, taux_mas = cas_mas / denominateur ) }Le tableau d'indicateurs — En R (suite)
par_commune <- tableau_indicateurs(muac, "commune") |> arrange(desc(taux_mag))
par_commune
Notes du présentateur
Le tableau porte volontairementdepistesetdenominateuren colonnes distinctes. Ils diffèrent des lignes sans aucune évaluation, et un lecteur qui voit les deux peut juger sur quelle part du registre repose le taux. Un tableau ne rapportant que le taux le dissimule entièrement. Exécutez-le : le taux de MAG global s'établit autour de 8,6 % et la MAS autour de 2,2 %, avec une amplitude d'environ 5 % à 15 % selon les communes. Une commune franchit le seuil d'urgence de 15 % ; la meilleure en est loin. Ces valeurs sont énoncées dans les notes de qualité du jeu de données précisément pour que vous puissiez contrôler votre travail — si votre MAG ressort à 30 %, vous avez un bogue, pas une famine.La désagrégation — En Python
muac["tranche_age"] = pd.cut(
    muac["age_months"],
    bins=[6, 24, 60],
    labels=["6-23 mois", "24-59 mois"],
    right=False,
)

par_sexe = tableau_indicateurs(muac, ["commune", "sex"])
par_age = tableau_indicateurs(muac, "tranche_age")

print(par_age.round(4))
Notes du présentateur
Le cadre logique demandait commune, sexe et tranche d'âge. La tranche d'âge doit être construite, et ses bornes sont un choix à énoncer.La désagrégation — En R
muac <- muac |>
  mutate(
    tranche_age = cut(
      age_months,
      breaks = c(6, 24, 60),
      labels = c("6-23 mois", "24-59 mois"),
      right = FALSE
    )
  )

par_sexe <- tableau_indicateurs(muac, c("commune", "sex"))
par_age <- tableau_indicateurs(muac, "tranche_age")

par_age
Notes du présentateur
right = FALSErend les bandes fermées à gauche : de 6 à 23 mois révolus, puis de 24 à 59. L'inverse place les enfants de 24 mois dans la tranche inférieure, ce qui déplace légèrement tous les taux et reste invisible dans le résultat. Énoncez la convention dans la fiche de référence. Rappelez-vous le problème d'âge manquant de la leçon 5. La désagrégation par âge exclut nécessairement les lignes sans âge, et Gros-Morne y est surreprésentée. Publiez le tableau par âge avec cette réserve attachée, ou publiez-le en excluant Gros-Morne et dites-le.Énoncez votre degré d'incertitude
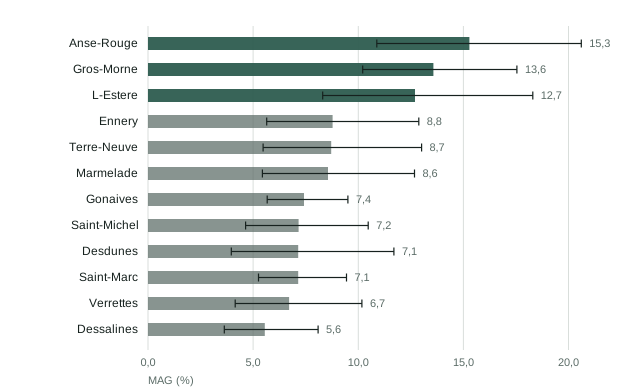
Malnutrition aiguë globale par commune, avec intervalles de confiance à 95 %. Seules les trois communes mises en évidence ont un intervalle dégagé de la médiane du district ; les neuf autres se recouvrent. Notes du présentateur
Un taux calculé sur 340 enfants n'est pas la même affirmation qu'un taux calculé sur 12. Attachez-y un intervalle.Énoncez votre degré d'incertitude
- Lisez les moustaches, non l'ordre — Neuf de ces douze communes ont des intervalles qui se recouvrent : le dépistage ne…
Notes du présentateur
Lisez les moustaches, non l'ordre. Neuf de ces douze communes ont des intervalles qui se recouvrent : le dépistage ne soutient donc pas l'affirmation que l'une serait pire qu'une autre. Un tableau trié par taux invite exactement à cette affirmation, et la figure est le moyen le plus rapide de l'arrêter — les trois barres dont l'intervalle dégage la médiane sont un constat, l'écart entre la quatrième et la cinquième n'en est pas un.Énoncez votre degré d'incertitude — En Python (suite)
from scipy.stats import beta def intervalle(succes, n, confiance=0.95): if n == 0: return (np.nan, np.nan) bas = beta.ppf((1 - confiance) / 2, succes, n - succes + 1) if succes > 0 else 0.0 haut = beta.ppf(1 - (1 - confiance) / 2, succes + 1, n - succes) if succes < n else 1.0 return (bas, haut) bornes = par_commune.apply( lambda r: intervalle(r["cas_mag"], r["denominateur"]), axis=1 ) par_commune["mag_bas"] = [b[0] for b in bornes] par_commune["mag_haut"] = [b[1] for b in bornes]Énoncez votre degré d'incertitude — En Python (suite)
print(par_commune[["commune", "denominateur", "taux_mag", "mag_bas", "mag_haut"]].round(4))Énoncez votre degré d'incertitude — En R
intervalle <- function(cas, n) {
  if (n == 0) return(c(NA_real_, NA_real_))
  test <- binom.test(cas, n)
  test$conf.int
}

par_commune <- par_commune |>
  rowwise() |>
  mutate(
    mag_bas  = intervalle(cas_mag, denominateur)[1],
    mag_haut = intervalle(cas_mag, denominateur)[2]
  ) |>
  ungroup()

par_commune |> select(commune, denominateur, taux_mag, mag_bas, mag_haut)
Notes du présentateur
Regardez à présent le classement. Plusieurs communes ont des intervalles qui se recouvrent, ce qui signifie que l'ordre entre elles n'est pas soutenu par les données. Si la décision éclairée par ce tableau est « quelle commune reçoit le site PCIMA supplémentaire », cela compte énormément — et un tableau sans intervalles vous aurait laissé les classer avec une assurance infondée. Il s'agit par ailleurs d'un recensement des enfants dépistés et non d'un échantillon probabiliste : l'intervalle ne décrit donc que la variation d'échantillonnage. Il ne dit rien sur la question de savoir si les enfants venus au dépistage ressemblent à ceux qui n'y sont pas venus, ce qui constitue généralement la plus grande source d'erreur et relève de la section des limites.Mettez-le en forme pour le rapport — En Python
rapport = par_commune.assign( mag=lambda d: (d["taux_mag"] * 100).round(1).astype(str) + "%", ic=lambda d: "(" + (d["mag_bas"] * 100).round(1).astype(str) + " - " + (d["mag_haut"] * 100).round(1).astype(str) + ")", )[["commune", "depistes", "denominateur", "cas_mag", "mag", "ic"]] rapport.columns = [ "Commune", "Dépistés", "Évalués", "Cas MAG", "Taux MAG", "IC 95%", ] rapport.to_csv("output/tables/mag-par-commune.csv", index=False) print(rapport.to_string(index=False))Mettez-le en forme pour le rapport — En R
rapport <- par_commune |>
  transmute(
    Commune     = commune,
    `Dépistés`  = depistes,
    `Évalués`   = denominateur,
    `Cas MAG`   = cas_mag,
    `Taux MAG`  = sprintf("%.1f%%", taux_mag * 100),
    `IC 95%`    = sprintf("(%.1f - %.1f)", mag_bas * 100, mag_haut * 100)
  )

readr::write_csv(rapport, "output/tables/mag-par-commune.csv")
rapport
Notes du présentateur
Chaque colonne de ce tableau est défendable : vous pouvez dire d'où vient chaque chiffre, ce qu'il a compté, ce qu'il n'a pas compté, et avec quelle incertitude.La suite
- La dernière leçon fait en sorte que tout cela s'exécute à nouveau — sur l'export du trimestre suivant, sur le portable de quelqu'un d'autre, sans rien modifier.
Notes du présentateur
La dernière leçon fait en sorte que tout cela s'exécute à nouveau — sur l'export du trimestre suivant, sur le portable de quelqu'un d'autre, sans rien modifier.