Retour à la leçon·Leçon 2 sur 8·Avant de modifier quoi que ce soit
Une non-réponse qui n'est pas un accident
Le même diaporama que les téléchargements, rendu sous forme de page. Lancez le diaporama pour le présenter en plein écran — les flèches ou un clic avancent d'une diapositive, Échap quitte.
Ce que couvre cette leçon
- 5,4 %, ce n'est pas un constat
- Décomposez par groupe avant toute chose
- Puis par période, à l'intérieur du groupe qui ressort
- Nommez le mécanisme, dans des mots que le rapport peut porter
- Chiffrez ce que leur suppression coûte
- Les trois réponses, et le moment où chacune est honnête
- Des lignes manquantes, pas seulement des valeurs
- La suite
Notes du présentateur
Un taux de complétude global masque la seule chose qui compte. Décomposer la non-réponse par site et par semaine, nommer le mécanisme, et chiffrer ce que la suppression des lignes incomplètes fait à votre classement.5,4 %, ce n'est pas un constat
- Un taux de complétude ne signifie quelque chose qu'une fois qu'on sait où sont les trous — Une non-réponse dispersée…
Notes du présentateur
Le registre n'a pas d'age_monthssur 226 de ses 4 218 lignes. Présenté comme « le jeu de données est complet à 94,6 % », ce chiffre est pire qu'inutile — il invite le lecteur à conclure que le problème est petit, et il ne l'est pas, parce qu'il n'est pas réparti. Un taux de complétude ne signifie quelque chose qu'une fois qu'on sait où sont les trous. Une non-réponse dispersée coûte de la précision. Une non-réponse concentrée coûte la réponse. Cette leçon montre comment savoir dans quel cas vous êtes, et quoi en dire.Décomposez par groupe avant toute chose — En Python
by_commune = ( muac.assign(missing_age=muac["age_months"].isna()) .groupby("commune") .agg(missing=("missing_age", "mean"), n=("missing_age", "size")) .sort_values("missing", ascending=False) ) print((by_commune["missing"] * 100).round(1))Décomposez par groupe avant toute chose — En R
muac |> group_by(commune) |> summarise(missing = mean(is.na(age_months)), n = n()) |> arrange(desc(missing)) |> mutate(missing = round(100 * missing, 1))Décomposez par groupe avant toute chose
Commune Âge manquant Lignes Gros-Morne 17,7 % 361 Anse-Rouge 5,7 % 229 Saint-Michel 5,1 % 335 Dessalines 4,9 % 450 Ennery 3,0 % 263 Notes du présentateur
Onze communes se situent entre 3 % et 6 %. Une seule est à 17,7 %. Ce n'est pas une distribution à longue traîne, ce sont onze communes avec une non-réponse ordinaire et une commune avec un problème.Puis par période, à l'intérieur du groupe qui ressort — En Python
gros_morne = muac[muac["commune"] == "Gros-Morne"].copy() gros_morne["week"] = gros_morne["screening_date"].dt.to_period("W").dt.start_time print( gros_morne.groupby("week")["age_months"] .apply(lambda s: s.isna().mean()) .sort_values(ascending=False) .head() )Puis par période, à l'intérieur du groupe qui ressort — En R
muac |>
  filter(commune == "Gros-Morne") |>
  mutate(week = lubridate::floor_date(screening_date, "week", week_start = 1)) |>
  group_by(week) |>
  summarise(missing = mean(is.na(age_months)), n = n()) |>
  arrange(desc(missing)) |>
  head()
Notes du présentateur
La semaine du 10 juin — 54 dépistages sur 85, soit 63,5 %. Toutes les autres semaines de cette commune sont sous les 10 %. Ce n'est plus une statistique de qualité des données. C'est une équipe, une semaine, un formulaire de tablette dont le champ âge était mal configuré, et cela porte un nom, une date et probablement une personne qui s'en souvient. Une non-réponse qui se ramène à un événement est une non-réponse sur laquelle on peut poser une question, et souvent la corriger à la source.Nommez le mécanisme, dans des mots que le rapport peut porter
- Manquant complètement au hasard. Les trous ne dépendent de rien, pas même de la valeur absente. Supprimer ces…
- Manquant au hasard. Les trous dépendent de quelque chose d'observé — une commune, une semaine, un enquêteur. Les…
- Manquant non au hasard. Les trous dépendent de la valeur absente elle-même. Les enfants les plus malades sont ceux…
Notes du présentateur
La littérature statistique distingue trois catégories. Vous n'avez pas besoin de la notation, mais bien de la distinction, car elle décide de ce que vous avez le droit de faire. La non-réponse sur l'âge est ici manquante au hasard — elle dépend de la commune et de la semaine, toutes deux enregistrées. Les codes-99du PB sont peut-être pires — si la mesure a été sautée lorsque l'enfant était agité, et que l'agitation est corrélée à la maladie, alors c'est du manquant non au hasard, et aucun code ne vous le dira.Nommez le mécanisme, dans des mots que le rapport peut porter
La catégorie n'est pas une subtilité statistique. C'est la différence entre « nous avons supprimé 226 lignes » et « nous avons supprimé 226 lignes, dont 54 d'une seule commune en une seule semaine, ce qui déplace le taux de cette commune de 1,1 point ».
Chiffrez ce que leur suppression coûte — En Python
def gam_rate(df):
    assessed = df["muac_mm"].notna() | df["oedema"].notna()
    cases = assessed & ((df["muac_mm"] < 125) | (df["oedema"] == True))
    return pd.Series({
        "assessed": int(assessed.sum()),
        "cases": int(cases.sum()),
        "rate": round(cases.sum() / assessed.sum(), 3),
    })


all_rows = muac.groupby("commune").apply(gam_rate)
complete = muac[muac["age_months"].notna()].groupby("commune").apply(gam_rate)

comparison = all_rows.join(complete, rsuffix="_complete")
comparison["shift"] = comparison["rate_complete"] - comparison["rate"]
print(comparison.sort_values("shift"))
Notes du présentateur
C'est l'étape que presque personne ne fait, et elle prend six lignes. Calculez l'indicateur deux fois — une fois sur tout, une fois sur les seuls cas complets.Chiffrez ce que leur suppression coûte — En R (suite)
gam_rate <- function(df) { df |> mutate( assessed = !is.na(muac_mm) | !is.na(oedema), case = assessed & (muac_mm < 125 | oedema) ) |> summarise( assessed = sum(assessed, na.rm = TRUE), cases = sum(case, na.rm = TRUE), rate = round(cases / assessed, 3), .by = commune ) } comparison <- gam_rate(muac) |> left_join(gam_rate(filter(muac, !is.na(age_months))),Chiffrez ce que leur suppression coûte — En R (suite)
by = "commune", suffix = c("", "_complete")) |> mutate(shift = rate_complete - rate) |> arrange(shift)Chiffrez ce que leur suppression coûte
Commune Toutes lignes Cas complets Écart Gros-Morne 14,5 % 13,4 % -1,1 pt Anse-Rouge 15,6 % 16,5 % +0,9 pt Dessalines 5,8 % 5,4 % -0,4 pt Saint-Michel 7,6 % 7,6 % 0,0 pt Notes du présentateur
Lisez les deux premières lignes ensemble. Sur toutes les lignes, Gros-Morne est deuxième plus touchée à 14,5 %, avec 1,7 point d'avance sur la commune suivante. Sur les cas complets, elle est à 13,4 % et la commune suivante à 13,3 %. L'écart entre la deuxième et la troisième place passe de 1,7 point à 0,1 — autrement dit, le classement que vous poseriez sur la table d'une réunion du cluster nutrition dépend d'un formulaire mal configuré dans une commune au mois de juin. Remarquez aussi que rien ici n'a franchi de seuil au point de changer une décision. Dites-le également. Un test de sensibilité qui ne trouve aucun effet est un résultat, et c'est celui qui permet d'arrêter de s'inquiéter.Les trois réponses, et le moment où chacune est honnête
- Les supprimer, et déclarer la suppression — Légitime quand la non-réponse est dispersée et que vous l'avez montré
- Les garder, dans une catégorie à part — Souvent la bonne réponse pour une variable catégorielle, car « non renseigné »…
- Imputer — prudemment, et rarement — Pour une variable servant à désagréger plutôt qu'à calculer, remplir l'âge…
Notes du présentateur
Les supprimer, et déclarer la suppression. Légitime quand la non-réponse est dispersée et que vous l'avez montré. La déclaration n'est pas facultative — « n = 3 992 sur 4 218 ; 226 lignes exclues pour âge manquant » a sa place dans la note de bas de tableau, pas dans votre tête. Les garder, dans une catégorie à part. Souvent la bonne réponse pour une variable catégorielle, car « non renseigné » est un vrai constat sur le programme. Une colonne de complétude à côté de la colonne d'indicateur en dit plus que chacune séparément. Imputer — prudemment, et rarement. Pour une variable servant à désagréger plutôt qu'à calculer, remplir l'âge manquant par l'âge médian de la même commune et du même mois est défendable si vous marquez chaque ligne imputée et rapportez l'indicateur des deux façons. Pour une variable du numérateur, imputer revient à inventer le constat.Les trois réponses, et le moment où chacune est honnête — En Python
muac["age_imputed"] = muac["age_months"].isna() muac["age_months_filled"] = muac.groupby("commune")["age_months"].transform( lambda s: s.fillna(s.median()) )Les trois réponses, et le moment où chacune est honnête — En R
muac <- muac |> mutate(age_imputed = is.na(age_months)) |> group_by(commune) |> mutate(age_months_filled = ifelse(is.na(age_months), median(age_months, na.rm = TRUE), age_months)) |> ungroup()Les trois réponses, et le moment où chacune est honnête
- La colonne de marquage est l'essentiel — Une valeur imputée qu'on ne distingue plus d'une valeur mesurée a cessé d'être…
Notes du présentateur
La colonne de marquage est l'essentiel. Une valeur imputée qu'on ne distingue plus d'une valeur mesurée a cessé d'être une estimation pour devenir une affirmation.Des lignes manquantes, pas seulement des valeurs
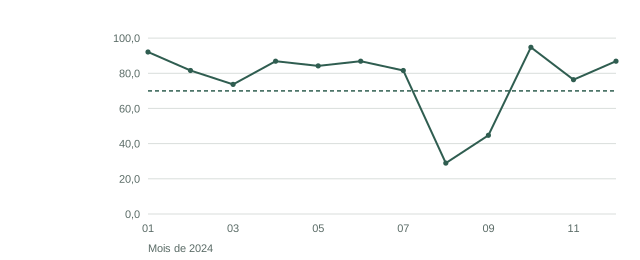
Part des formations sanitaires ayant transmis un rapport mensuel au cours de 2024. L'effondrement d'août et septembre bouge de concert dans tout le district, ce qui en fait un événement de rapportage et non une défaillance de formation sanitaire. Notes du présentateur
La non-réponse la plus difficile est celle sans case vide, parce que la ligne n'est pas là du tout.Des lignes manquantes, pas seulement des valeurs — En Python
vax["reported"] = vax["report_submitted"] == True

reporting_rate = vax.groupby("period")["reported"].mean()
coverage = (
    vax[vax["reported"]]
    .groupby("period")
    .apply(lambda g: g["doses_administered"].sum() / g["target_population"].sum())
)
print(pd.DataFrame({"reporting_rate": reporting_rate, "coverage": coverage}))
Notes du présentateur
Dans l'extraction vaccinale de routine, une formation sanitaire qui n'a pas rapporté n'est pas absente — elle est présente avecdoses_administeredà zéro etreport_submittedàfalse. Six cent quarante-deux lignes sont dans cet état. Calculez la couverture sans les séparer et toute formation sanitaire silencieuse devient une formation sanitaire n'ayant vacciné personne.Des lignes manquantes, pas seulement des valeurs — En R
vax |>
  summarise(
    reporting_rate = mean(report_submitted),
    coverage = sum(doses_administered[report_submitted]) /
               sum(target_population[report_submitted]),
    .by = period
  )
Notes du présentateur
Deux chiffres, toujours publiés ensemble. La couverture calculée sur les formations sanitaires ayant rapporté, et le taux de complétude qui dit quelle part du district cela représente. Un taux de couverture unique qui inclut discrètement les structures silencieuses à son dénominateur est le défaut le plus répandu des données sanitaires de routine, et il tire toujours dans le même sens — vers le bas.La suite
- La non-réponse est un trou là où quelque chose devrait être.
Notes du présentateur
La non-réponse est un trou là où quelque chose devrait être. L'unité suivante traite du problème inverse — quelque chose qui est là deux fois. La leçon 3 demande si la colonne que vous traitez comme une clé en est réellement une, et montre ce que fait une jointure quand elle n'en est pas une.