Retour à la leçon·Leçon 5 sur 8·Rendre les données fiables
Établir ce qui ne va pas dans les données
Le même diaporama que les téléchargements, rendu sous forme de page. Lancez le diaporama pour le présenter en plein écran — les flèches ou un clic avancent d'une diapositive, Échap quitte.
Ce que couvre cette leçon
- Profiler avant d'analyser
- Vérification 1 : la complétude, par groupe et non globalement
- Vérification 2 : les valeurs implausibles
- Vérification 3 : les doublons, y compris ceux sans clé propre
- Vérification 4 : les contradictions internes
- Vérification 5 : un même objet codé de plusieurs manières
- Une fonction de profilage à conserver
- La suite
Notes du présentateur
Profiler méthodiquement un export récent — non-réponse par site et par semaine, mesures implausibles, doublons sans clé propre, et codes qui se contredisent entre eux.Profiler avant d'analyser
- Vous disposez d'un tableau ordonné aux types corrects.
Notes du présentateur
Vous disposez d'un tableau ordonné aux types corrects. Vous ne savez pas encore ce qu'il contient. L'instinct pousse à calculer l'indicateur et à regarder le chiffre. Résistez : le chiffre sera plausible quel que soit le défaut, et une fois que vous l'aurez vu, vous trouverez des raisons d'y croire. Profiler d'abord, décider ensuite, calculer en dernier. Cette leçon est le profilage. Cinq vérifications, classées par l'ampleur des dégâts qu'elles causent lorsqu'on les néglige.Vérification 1 : la complétude, par groupe et non globalement
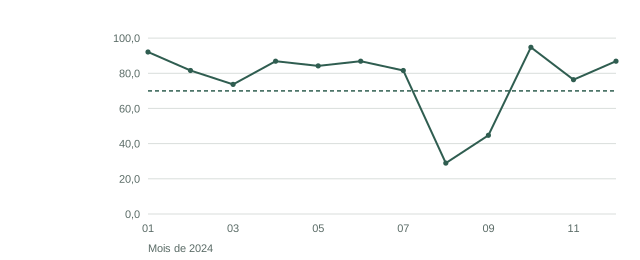
Part des formations sanitaires transmettant un rapport mensuel sur 2024. L'effondrement d'août et septembre touche tout le district, il n'est pas propre à une formation. Vérification 1 : la complétude, par groupe et non globalement — En Python
global_ = muac.isna().mean().sort_values(ascending=False)
print(global_)

par_commune = (
    muac.assign(age_manquant=muac["age_months"].isna())
    .groupby("commune")["age_manquant"]
    .agg(["mean", "size"])
    .sort_values("mean", ascending=False)
)
print(par_commune)
Notes du présentateur
Une formation qui n'a pas rapporté apparaît dans l'extrait comme des lignes à zéro : un graphique de complétude et un graphique de couverture ne disent donc pas la même chose — et lire le second sans le premier, c'est ainsi qu'une formation silencieuse devient une formation défaillante. Noter aussi que deux mois bougent ensemble : ce qui s'y est produit est un événement de district, et un signalement de qualité visant des formations individuelles sur cette fenêtre désignerait la mauvaise cible. Un taux de complétude unique ne sert quasiment à rien. Ce qui compte, c'est de savoir si la non-réponse se concentre, car une non-réponse concentrée biaise, alors qu'une non-réponse dispersée ne coûte le plus souvent que de la précision.Vérification 1 : la complétude, par groupe et non globalement — En R
muac |> summarise(across(everything(), ~ mean(is.na(.x)))) |> tidyr::pivot_longer(everything(), names_to = "colonne", values_to = "manquant") |> arrange(desc(manquant)) muac |> group_by(commune) |> summarise( age_manquant = mean(is.na(age_months)), n = n() ) |> arrange(desc(age_manquant))Vérification 1 : la complétude, par groupe et non globalement — En Python
gros_morne = muac[muac["commune"] == "Gros-Morne"].copy()
gros_morne["semaine"] = gros_morne["screening_date"].dt.to_period("W")

print(
    gros_morne.groupby("semaine")["age_months"]
    .apply(lambda s: s.isna().mean())
    .sort_values(ascending=False)
    .head()
)
Notes du présentateur
Appliquée à ce registre, la non-réponse globale deage_monthsavoisine 5 %, ce qui paraît tolérable. Ventilez-la et Gros-Morne est bien plus touchée que les autres. Ventilez également par semaine et tout se concentre sur une seule semaine de campagne, du 10 au 14 juin :Vérification 1 : la complétude, par groupe et non globalement — En R
muac |> filter(commune == "Gros-Morne") |> mutate(semaine = lubridate::floor_date(screening_date, "week")) |> group_by(semaine) |> summarise(age_manquant = mean(is.na(age_months)), n = n()) |> arrange(desc(age_manquant))Vérification 1 : la complétude, par groupe et non globalement
Une non-réponse qui se concentre sur un site ou une semaine fait la différence entre perdre de la précision et perdre la réponse. Ventilez-la toujours avant de décider quoi en faire.
Notes du présentateur
Ce n'est pas un désagrément de qualité des données. C'est une équipe, une semaine, un formulaire de tablette dont le champ âge était mal configuré — et cela signifie que supprimer les lignes incomplètes retire bien plus de Gros-Morne que de toute autre commune. Si vous classez ensuite les communes par taux de malnutrition, vous les avez en partie classées selon le formulaire de quelle équipe était défectueux.Vérification 2 : les valeurs implausibles — En Python
implausibles = muac[(muac["muac_mm"] < 80) | (muac["muac_mm"] > 220)]
print(implausibles[["child_id", "commune", "age_months", "muac_mm"]])

print(muac["muac_mm"].describe())
Notes du présentateur
Chaque secteur a ses limites physiques. Servez-vous-en. Pour le PB chez l'enfant de 6 à 59 mois, les valeurs inférieures à environ 80 mm ou supérieures à environ 220 mm ne sont pas des mesures : ce sont des erreurs de saisie. Le registre porte sept enregistrements où la mesure est restée en centimètres sans jamais être convertie, et qui apparaissent sous forme de valeurs inférieures à 40.Vérification 2 : les valeurs implausibles — En R
muac |> filter(muac_mm < 80 | muac_mm > 220) |> select(child_id, commune, age_months, muac_mm) summary(muac$muac_mm)Vérification 2 : les valeurs implausibles — En Python
print(muac["age_months"].describe())
print(muac[(muac["age_months"] < 6) | (muac["age_months"] > 59)].shape[0])
Notes du présentateur
Une valeur de 13,3 là où vous attendiez 133 est une erreur d'unité, et elle est récupérable : vous savez ce qu'elle devait être. Une valeur de 450 n'est pas récupérable et doit être traitée comme manquante. Distinguer les deux relève du jugement, et c'est pourquoi cela appartient au journal de nettoyage plutôt qu'à un filtre d'une ligne. Vérifiez aussi l'intervalle d'âge. Un programme de dépistage PB cible les 6 à 59 mois ; une ligne indiquant 72 mois est donc soit hors périmètre, soit une erreur de saisie, et laquelle des deux change votre dénominateur.Vérification 2 : les valeurs implausibles — En R
summary(muac$age_months) sum(muac$age_months < 6 | muac$age_months > 59, na.rm = TRUE)Vérification 3 : les doublons, y compris ceux sans clé propre — En Python
exacts = muac[muac.duplicated(keep=False)]
print(f"{len(exacts)} lignes dans des groupes de doublons exacts")

ids_repetes = muac[muac.duplicated(subset=["child_id"], keep=False)]
print(f"{len(ids_repetes)} lignes partageant un child_id")
Notes du présentateur
Les doublons exacts sont faciles :Vérification 3 : les doublons, y compris ceux sans clé propre — En R
sum(duplicated(muac)) muac |> group_by(child_id) |> filter(n() > 1) |> arrange(child_id)Vérification 3 : les doublons, y compris ceux sans clé propre — En Python
suspects = (
    muac.groupby(["commune", "screening_date", "age_months", "sex", "muac_mm"])
    .filter(lambda g: len(g) > 1)
    .sort_values(["commune", "screening_date", "muac_mm"])
)

print(suspects[["child_id", "commune", "screening_date", "age_months", "sex", "muac_mm"]])
Notes du présentateur
Ce registre compte douze doublons exacts, issus de formulaires soumis deux fois sur une mauvaise connexion. Ceux-là sont sans ambiguïté : la même soumission est arrivée deux fois, et un exemplaire doit disparaître. Le cas difficile est celui de l'enfant réenregistré sous un nouvel identifiant, qui ne partage aucune clé. Il y en a six dans ce fichier, repérables uniquement en appariant sur les attributs qui ne devraient pas coïncider par hasard :Vérification 3 : les doublons, y compris ceux sans clé propre — En R
muac |>
  group_by(commune, screening_date, age_months, sex, muac_mm) |>
  filter(n() > 1) |>
  arrange(commune, screening_date, muac_mm) |>
  select(child_id, commune, screening_date, age_months, sex, muac_mm)
Notes du présentateur
Prudence ici : deux enfants différents de même âge et de même sexe, dépistés dans la même commune le même jour, avec le même PB au millimètre près, c'est possible. Dans une grande campagne, c'est même probable. Cette vérification produit des suspects, non des doublons, et la résolution passe par un humain qui consulte le registre — pas par un appel àdrop_duplicates().Vérification 4 : les contradictions internes — En Python
contradiction_a = muac[
    muac["outcome"].isin(["referred-tsfp", "referred-otp", "referred-sc"])
    & muac["muac_mm"].isna()
]
print(len(contradiction_a))
Notes du présentateur
Des colonnes qui devraient concorder, et qui ne concordent pas. Ce registre porte deux défauts de ce type. Soixante-treize enregistrements portent une décision de référencement mais aucune valeur de PB — la colonne de décision et la colonne de mesure ont été remplies par deux personnes différentes :Vérification 4 : les contradictions internes — En R
muac |> filter(outcome %in% c("referred-tsfp", "referred-otp", "referred-sc"), is.na(muac_mm)) |> nrow()Vérification 4 : les contradictions internes — En Python
def decision_attendue(ligne):
    if pd.isna(ligne["muac_mm"]):
        return None
    if ligne["oedema"] is True or ligne["muac_mm"] < 115:
        return "referred-otp"
    if ligne["muac_mm"] < 125:
        return "referred-tsfp"
    return "no-action"

controle = muac.assign(attendu=muac.apply(decision_attendue, axis=1))
incoherents = controle[
    controle["attendu"].notna()
    & (controle["attendu"] == "no-action")
    & (controle["outcome"] != "no-action")
]
print(len(incoherents))
Notes du présentateur
Et neuf enregistrements portent une décision qui contredit leur propre mesure — un enfant mesuré à 140 mm marqué comme référé en prise en charge ambulatoire, ou un enfant à 110 mm marqué sans action. C'est ce que produit un écran de tablette mal effleuré.Vérification 4 : les contradictions internes — En R
muac |>
  mutate(
    attendu = case_when(
      is.na(muac_mm)             ~ NA_character_,
      oedema | muac_mm < 115     ~ "referred-otp",
      muac_mm < 125              ~ "referred-tsfp",
      TRUE                       ~ "no-action"
    )
  ) |>
  filter(!is.na(attendu), attendu == "no-action", outcome != "no-action") |>
  nrow()
Notes du présentateur
Notez que cette vérification encode une règle clinique. Elle ne vaut que ce que vaut la règle, et l'orientation vers un centre de stabilisation dépend de complications que le registre ne consigne pas — traitez donc une incohérence comme un signalement à examiner, non comme la preuve que la décision est fausse.Vérification 5 : un même objet codé de plusieurs manières — En Python
brut = pd.read_csv(CHEMIN, dtype={"oedema": "string"})
print(brut.groupby("commune")["oedema"].value_counts(dropna=False))
Notes du présentateur
La colonneoedemaest renseignée entrue/falsesur l'essentiel du fichier, mais Ennery et Desdunes ont utiliséY/Nau premier trimestre, et certaines lignes sont vides.Vérification 5 : un même objet codé de plusieurs manières — En R
read_csv(CHEMIN, col_types = cols(.default = col_character())) |>
  count(commune, oedema)
Notes du présentateur
Regardez toujours les valeurs textuelles brutes d'une colonne catégorielle avant de la convertir. Convertir d'abord puis compter les manquantes vous dit combien de lignes portaient une valeur inattendue ; regarder les valeurs brutes vous dit lesquelles, ce dont vous avez besoin pour juger si elles sont récupérables.Une fonction de profilage à conserver — En Python
def profiler(df, groupe=None):
    rapport = {
        "lignes": len(df),
        "colonnes": df.shape[1],
        "lignes_dupliquees": int(df.duplicated().sum()),
        "manquant": df.isna().mean().round(4).to_dict(),
    }
    if groupe:
        rapport["manquant_par_groupe"] = (
            df.isna().groupby(df[groupe]).mean().round(4).to_dict("index")
        )
    return rapport


import json
print(json.dumps(profiler(muac, groupe="commune"), indent=2, default=str))
Notes du présentateur
Emballez le tout pour qu'elle s'exécute sur chaque nouvel export sans être retapée.Une fonction de profilage à conserver — En R
profiler <- function(df, groupe = NULL) {
  out <- list(
    lignes = nrow(df),
    colonnes = ncol(df),
    lignes_dupliquees = sum(duplicated(df)),
    manquant = sapply(df, function(x) round(mean(is.na(x)), 4))
  )
  if (!is.null(groupe)) {
    out$manquant_par_groupe <- df |>
      group_by(.data[[groupe]]) |>
      summarise(across(everything(), ~ round(mean(is.na(.x)), 4)))
  }
  out
}

str(profiler(muac, groupe = "commune"))
Notes du présentateur
Exécutez ceci sur chaque export, enregistrez le résultat à côté des données, et vous disposez d'une trace de l'état du fichier à son arrivée. Cette trace est ce qui vous permettra de répondre six mois plus tard à la question « est-ce que ça a toujours été comme ça ? ».La suite
- Vous savez maintenant ce qui ne va pas.
Notes du présentateur
Vous savez maintenant ce qui ne va pas. La leçon suivante porte sur la décision à prendre face à chaque défaut — et, plus important encore, sur la manière de consigner ces décisions sous une forme qui survive à celui qui les a prises.