Retour à la leçon·Leçon 5 sur 8·Des valeurs qui ne peuvent pas être vraies
Des règles que le secteur vous a déjà données
Le même diaporama que les téléchargements, rendu sous forme de page. Lancez le diaporama pour le présenter en plein écran — les flèches ou un clic avancent d'une diapositive, Échap quitte.
Ce que couvre cette leçon
- « Cela semble faux » n'est pas une règle
- Les seuils existent déjà
- Des règles comme données, pas comme conditions
- Appliquer la table
- Bornes dures et bornes souples
- Des règles qui comparent deux colonnes
- Signalez, ne supprimez pas
- Le taux de signalement est lui-même un indicateur
- La suite
Notes du présentateur
Transformer « cela semble faux » en une table de règles avec une source, une gravité et un compte. Bornes dures face aux limites physiques, bornes souples face aux seuils du secteur, et la discipline du signalement plutôt que de la suppression.« Cela semble faux » n'est pas une règle
- Quiconque fait ce métier finit par acquérir l'œil.
Notes du présentateur
Quiconque fait ce métier finit par acquérir l'œil. Vous faites défiler une colonne, quelque chose accroche, vous allez voir. Cela marche, et cela ne passe pas à l'échelle, ne se transmet pas à la personne qui vous succédera, et ne se défend pas en revue — car la réponse à « pourquoi avez-vous supprimé cette ligne » est « elle semblait fausse ». Le remède consiste à écrire la règle : une condition, une source, une gravité et un compte. Une fois qu'elle existe sous cette forme, elle s'exécute sur le fichier du trimestre suivant, elle s'explique d'elle-même, et le nombre de lignes qu'elle a attrapées devient une ligne du journal de nettoyage.Les seuils existent déjà
Domaine Règle Source PB, 6-59 mois En dessous de 80 mm ou au-dessus de 220 mm, ce n'est pas une mesure OMS / pratique de terrain PCIMA Score Z poids-taille Hors de l'intervalle -5 à +5 de la référence Normes OMS 2006 de croissance Anthropométrie SMART Signaler les scores Z à plus de 3 ET de la moyenne de l'enquête Rapport de plausibilité SMART Quantité d'eau Moins de 15 litres par personne et par jour est sous le minimum Sphere Collecte d'eau Un aller-retour de plus de 30 minutes est un service limité, pas élémentaire Échelles de service JMP Chlore résiduel libre 0,2 à 2,0 mg/L au point de consommation Sphere / OMS Couverture Des doses administrées supérieures à la population cible demandent une explication Guide d'indicateurs UNICEF Notes du présentateur
Vous n'inventez presque jamais une limite. Ce secteur est exceptionnellement bien pourvu en seuils publiés et défendables, et s'en servir est ce qui fait d'une règle une règle plutôt qu'une opinion.Les seuils existent déjà
- Citez la source dans la règle — Un seuil accompagné d'une référence survit à la contestation ; le même chiffre sans…
Notes du présentateur
Citez la source dans la règle. Un seuil accompagné d'une référence survit à la contestation ; le même chiffre sans référence se rediscute chaque trimestre.Des règles comme données, pas comme conditions — En Python (suite)
RULES = [
    {
        "id": "muac-range",
        "column": "muac_mm",
        "severity": "error",
        "source": "WHO / CMAM field practice",
        "test": lambda d: d["muac_mm"].between(80, 220) | d["muac_mm"].isna(),
        "message": "MUAC outside 80-220 mm",
    },
    {
        "id": "muac-unit-error",
        "column": "muac_mm",
        "severity": "warning",
        "source": "unit check, cm entered as mm",
        "test": lambda d: ~d["muac_mm"].between(1, 40),
        "message": "MUAC looks like centimetres",
Notes du présentateur
Écrivez les règles sous forme d'une table que le code parcourt. Deux raisons, et c'est la seconde qui compte. La première est évidente — ajouter une règle revient à ajouter une ligne. La seconde est qu'une table de règles peut être comptée, rapportée et comparée : vous pouvez afficher combien de lignes chaque règle a attrapées, comparer au trimestre précédent, et coller l'ensemble dans le journal de nettoyage sans le réécrire en prose.Des règles comme données, pas comme conditions — En Python (suite)
}, { "id": "age-in-scope", "column": "age_months", "severity": "warning", "source": "CMAM screening protocol, 6-59 months", "test": lambda d: d["age_months"].between(6, 59) | d["age_months"].isna(), "message": "age outside the screening window", }, ]Des règles comme données, pas comme conditions — En R
RULES <- tibble::tribble( ~id, ~column, ~severity, ~source, ~message, "muac-range", "muac_mm", "error", "WHO / CMAM field practice", "MUAC outside 80-220 mm", "muac-unit-error", "muac_mm", "warning", "unit check, cm entered as mm", "MUAC looks like centimetres", "age-in-scope", "age_months", "warning", "CMAM screening protocol, 6-59 mo", "age outside the screening window" ) TESTS <- list( `muac-range` = function(d) dplyr::between(d$muac_mm, 80, 220) | is.na(d$muac_mm), `muac-unit-error` = function(d) !dplyr::between(d$muac_mm, 1, 40), `age-in-scope` = function(d) dplyr::between(d$age_months, 6, 59) | is.na(d$age_months) )Des règles comme données, pas comme conditions
- Chaque test réussit sur une valeur manquante — C'est délibéré et cela prend constamment les gens en défaut :
NA < 80…
Notes du présentateur
Chaque test réussit sur une valeur manquante. C'est délibéré et cela prend constamment les gens en défaut :NA < 80n'est pas faux, c'est inconnu, et une règle qui traite l'inconnu comme une infraction rapportera votre non-réponse deux fois — une fois comme non-réponse et une fois comme valeur implausible. La non-réponse est le problème de la leçon 2. Gardez les deux séparés.- Chaque test réussit sur une valeur manquante — C'est délibéré et cela prend constamment les gens en défaut :
Appliquer la table — En Python (suite)
def apply_rules(df, rules): results = [] flags = pd.DataFrame(index=df.index) for rule in rules: ok = rule["test"](df) flags[rule["id"]] = ~ok results.append({ "rule": rule["id"], "severity": rule["severity"], "column": rule["column"], "failed": int((~ok).sum()), "share": round((~ok).mean(), 4), "source": rule["source"], }) return pd.DataFrame(results), flagsAppliquer la table — En Python (suite)
report, flags = apply_rules(muac, RULES) print(report.to_string(index=False))Appliquer la table — En R
apply_rules <- function(df, rules, tests) { flags <- purrr::map_dfc(rules$id, function(id) { tibble::tibble(!!id := !tests[[id]](df)) }) report <- rules |> dplyr::mutate( failed = purrr::map_int(id, ~ sum(flags[[.x]], na.rm = TRUE)), share = round(failed / nrow(df), 4) ) list(report = report, flags = flags) } out <- apply_rules(muac, RULES, TESTS) out$reportAppliquer la table
Règle Gravité Échecs Part muac-range error 7 0,17 % muac-unit-error warning 7 0,17 % age-in-scope warning 0 0,00 % Notes du présentateur
Sept lignes échouent aux deux règles sur le PB, ce qui est la réponse souhaitée : les mêmes sept enregistrements sont hors bornes et ressemblent à des centimètres, donc il s'agit d'une erreur d'unité et non de sept fautes sans rapport. Deux règles qui concordent constituent un indice sur la cause ; une règle isolée dirait seulement que quelque chose ne va pas.age-in-scopen'attrape rien, et cela mérite d'être conservé aussi. Une règle qui ne se déclenche jamais coûte une ligne et prouve que la contrainte tient — et le jour où elle se déclenche, elle vous dit que le programme a changé.Bornes dures et bornes souples
- Les bornes dures sont physiquement ou logiquement impossibles. Une taille de ménage négative, un PB de 450 mm, une…
- Les bornes souples sont implausibles mais possibles. Dix litres par personne et par jour est sous le minimum…
Notes du présentateur
Toutes les règles ne veulent pas dire la même chose, et les confondre est la façon dont un script de nettoyage se met à supprimer de vraies données. L'enquête EAH montre à quel point il est facile de confondre les deux. Douze ménages déclarent plus de 60 litres par personne et par jour, contre une médiane autour de quinze. Soixante litres par personne n'est pas impossible ; c'est ce que consomme réellement un ménage doté d'un branchement de cour et d'un jardin. Mais dans un fichier où quelques enquêteurs ont noté la consommation totale du ménage dans une colonne par personne, c'est aussi exactement l'allure de cette erreur.Bornes dures et bornes souples — En Python
suspect = wash[wash["litres_per_person_day"] > 60][ ["household_id", "community", "household_size", "litres_per_person_day", "water_source"] ] suspect["implied_total"] = suspect["litres_per_person_day"] * suspect["household_size"] print(suspect)Bornes dures et bornes souples — En R
wash |>
  filter(litres_per_person_day > 60) |>
  mutate(implied_total = litres_per_person_day * household_size) |>
  select(household_id, community, household_size, litres_per_person_day,
         water_source, implied_total)
Notes du présentateur
Regardezimplied_total. Si un ménage de sept personnes est enregistré à 140 litres par personne, le total implicite est de 980 litres par jour transportés à la main, ce qui n'arrive pas. La règle qui tranche une valeur ambiguë est généralement une deuxième colonne, pas un seuil plus serré. Le même piège se loge dans le temps de collecte. Quarante-deux ménages déclarent un aller-retour de moins de six minutes depuis une source qui n'est pas sur leur parcelle. Certains sont un robinet au bout de la rue. D'autres sont un enquêteur qui a écrit des heures dans un champ en minutes. Rien dans la colonne ne les distingue, et la règle honnête signale les quarante-deux pour relecture au lieu de prétendre savoir lesquels sont lesquels.Des règles qui comparent deux colonnes — En Python
CROSS_RULES = [
    {
        "id": "referral-without-measurement",
        "severity": "warning",
        "test": lambda d: ~(d["outcome"].str.startswith("referred") & d["muac_mm"].isna()),
        "message": "referred but no MUAC recorded",
    },
    {
        "id": "outcome-contradicts-muac",
        "severity": "warning",
        "test": lambda d: ~((d["muac_mm"] >= 125) & (d["oedema"] != True)
                            & (d["outcome"] != "no-action")),
        "message": "no-action expected from the measurement",
    },
]
Notes du présentateur
Les règles les plus utiles portent rarement sur la plage d'une seule colonne. Elles portent sur deux colonnes qui doivent concorder.Des règles qui comparent deux colonnes — En R
CROSS_TESTS <- list(
  `referral-without-measurement` = function(d)
    !(startsWith(d$outcome, "referred") & is.na(d$muac_mm)),
  `outcome-contradicts-muac` = function(d)
    !(d$muac_mm >= 125 & !d$oedema & d$outcome != "no-action")
)
Notes du présentateur
Dix enregistrements portent une décision de référencement sans mesure derrière, et neuf portent une sortie que leur propre mesure contredit. Aucun des deux n'est impossible — un enfant peut être référé sur jugement clinique, et un référencement peut être justifié pour une raison que le registre ne contient pas. Mais les deux méritent un coup de téléphone, et aucun n'est repérable en regardant l'une ou l'autre colonne isolément.Signalez, ne supprimez pas — En Python
muac = muac.join(flags.add_prefix("flag_"))
muac["flag_any_error"] = flags[[r["id"] for r in RULES if r["severity"] == "error"]].any(axis=1)
Notes du présentateur
La règle ajoute une colonne. Elle ne retire pas de ligne.Signalez, ne supprimez pas — En R
muac <- dplyr::bind_cols(muac, dplyr::rename_with(out$flags, ~ paste0("flag_", .x))) muac$flag_any_error <- dplyr::if_any(dplyr::starts_with("flag_"), identity)Signalez, ne supprimez pas
- Le compte reste disponible. « 4 218 dépistages, 7 exclus pour mesure implausible » exige les deux nombres, et un…
- L'exclusion est réversible. Un relecteur en désaccord avec une règle peut relancer l'analyse sans elle, en une…
- Les signalements sont analysables. Ce qui nous amène à la dernière section.
Notes du présentateur
Trois choses que cela vous apporte et qu'un filtre ne donne pas. Appliquez l'exclusion une seule fois, au moment du calcul, et dites-le.Signalez, ne supprimez pas — En Python
analysis = muac[~muac["flag_any_error"]] print(f"{len(muac)} screenings, {len(analysis)} analysed, " f"{muac['flag_any_error'].sum()} excluded")Signalez, ne supprimez pas — En R
analysis <- muac |> filter(!flag_any_error) sprintf("%d screenings, %d analysed, %d excluded", nrow(muac), nrow(analysis), sum(muac$flag_any_error))Le taux de signalement est lui-même un indicateur
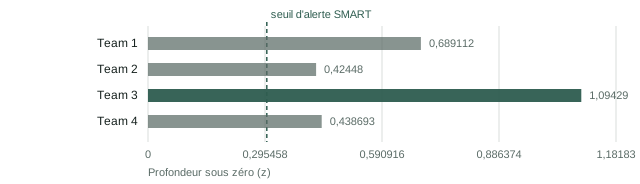
Score Z poids-pour-taille moyen par équipe de mesure dans l'enquête SMART, tracé en profondeur sous zéro. Les grappes ayant été attribuées aux équipes indépendamment de l'état nutritionnel, un écart de cette ampleur entre équipes est un défaut de mesure et non une différence réelle entre populations. Notes du présentateur
Une fois que les signalements sont des colonnes, regroupez-les comme n'importe quoi d'autre — et ce qui revient est une affirmation sur la collecte des données plutôt que sur les enfants.Le taux de signalement est lui-même un indicateur — En Python
print(muac.groupby("commune")[["flag_muac_unit_error", "flag_any_error"]].mean())Le taux de signalement est lui-même un indicateur — En R
muac |> summarise(across(starts_with("flag_"), mean), .by = commune)Le taux de signalement est lui-même un indicateur
Une règle qui se déclenche partout est une règle sur le monde. Une règle qui se déclenche à un seul endroit est une règle sur une équipe.
Notes du présentateur
Si une commune, une équipe ou un enquêteur concentre l'essentiel d'un signalement, le constat n'est pas dans les données — il est dans la supervision. C'est une chose bien plus utile à mettre dans un rapport mensuel qu'un chiffre corrigé, parce qu'elle est actionnable : l'équipe peut être reformée, et le fichier du trimestre suivant sera meilleur au lieu d'être simplement nettoyé.La suite
- Toutes les règles vues jusqu'ici comparent une valeur à un nombre.
Notes du présentateur
Toutes les règles vues jusqu'ici comparent une valeur à un nombre. La leçon suivante traite des valeurs qu'il faut comparer à une liste — les noms de sites et de villages en texte libre qui arrivent en quatre graphies, où l'autorité est une liste administrative et où le plus dur est de refuser d'inventer un appariement.