Retour à la leçon·Leçon 6 sur 8·Travailler le tableau
Regrouper jusqu'à un numérateur et un dénominateur
Le même diaporama que les téléchargements, rendu sous forme de page. Lancez le diaporama pour le présenter en plein écran — les flèches ou un clic avancent d'une diapositive, Échap quitte.
Ce que couvre cette leçon
- Un indicateur, ce sont deux nombres
- L'agrégation nommée
- Deux réglages par défaut qui changent un dénominateur
- Regrouper sur plusieurs clés
- transform : une statistique de groupe sur chaque ligne
- apply, et pourquoi l'éviter
- Les tableaux croisés se lisent mieux dans un rapport
- Écrire le résultat
- Ce qui vient ensuite
Notes du présentateur
groupby, agrégation nommée, et les deux réglages par défaut qui changent silencieusement un dénominateur — groupes manquants écartés et catégories non observées. Produire les deux moitiés d'un indicateur en une seule opération pour qu'elles ne puissent pas diverger.Un indicateur, ce sont deux nombres — En Python (suite)
import pandas as pd

muac = read_register(RAW / "muac-screening-artibonite-2024.v1.csv")

measured = muac["muac_mm"].notna()
gam = measured & (muac["muac_mm"] < 125)

by_commune = (
    muac.assign(measured=measured, gam=gam)
    .groupby("commune")
    .agg(
        screened=("child_id", "size"),
        measured=("measured", "sum"),
        gam_cases=("gam", "sum"),
    )
)
Notes du présentateur
Presque tout chiffre rapporté dans ce secteur est un numérateur sur un dénominateur, et presque toute dispute sur un chiffre est une dispute sur le dénominateur. La conséquence pratique pour votre code : calculez les deux dans la même opération. Deux calculs séparés divergent. L'un reçoit un filtre que l'autre n'a pas, quelqu'un modifie une ligne, et le rapport devient un chiffre que personne ne peut reconstituer.Un indicateur, ce sont deux nombres — En Python (suite)
by_commune["gam_rate"] = (by_commune["gam_cases"] / by_commune["measured"]).round(3)Un indicateur, ce sont deux nombres — Exemple
             screened  measured  gam_cases  gam_rate
commune
Gros-Morne        361       351         48     0.137
Anse-Rouge        229       223         30     0.135
L-Estere          189       187         18     0.096
Terre-Neuve       241       235         21     0.089
Notes du présentateur
Trois colonnes, et chacune porte quelque chose.screenedest le nombre d'enfants venus ;measuredle nombre ayant produit un PB exploitable, et c'est le dénominateur ;gam_casesest le numérateur. Publier le taux sans le dénominateur à côté, c'est ainsi que la dispute commence. Noter quescreenedetmeasureddiffèrent — 4 218 enfants ont été dépistés et 4 146 ont un PB. Diviser par le mauvais décale le taux du district assez pour compter et trop peu pour se voir.L'agrégation nommée — En Python
.agg(
    nom_de_sortie=("colonne_d_entree", "fonction"),
    ...
)
Notes du présentateur
La forme employée ci-dessus est celle à standardiser :L'agrégation nommée — En Python
muac.groupby("commune")["muac_mm"].mean()               # une colonne, une fonction
muac.groupby("commune").agg({"muac_mm": ["mean", "std"]})  # colonnes MultiIndex
Notes du présentateur
Elle nomme la colonne de sortie à l'endroit où l'agrégation est définie : plus de seconde étape pour renommermuac_mm_meanen quelque chose de compréhensible, et pas d'index de colonnes à plusieurs niveaux à aplatir. Les formes plus anciennes fonctionnent encore et méritent d'être reconnues dans le code d'autrui :L'agrégation nommée — En Python
def share_below(series, threshold=125):
    valid = series.dropna()
    return (valid < threshold).mean() if len(valid) else float("nan")

muac.groupby("commune").agg(
    gam_rate=("muac_mm", share_below),
    n=("muac_mm", "count"),
)
Notes du présentateur
La seconde produit des colonnes comme("muac_mm", "mean"), qu'il faut ensuite aplatir. L'agrégation nommée évite le problème plutôt que de le résoudre. Les fonctions peuvent être les vôtres :countexclut les manquants ;sizeles inclut. Cette seule distinction fait la différence entre les deux dénominateurs ci-dessus, et mérite d'être énoncée à voix haute chaque fois que vous employez l'un des deux.Deux réglages par défaut qui changent un dénominateur
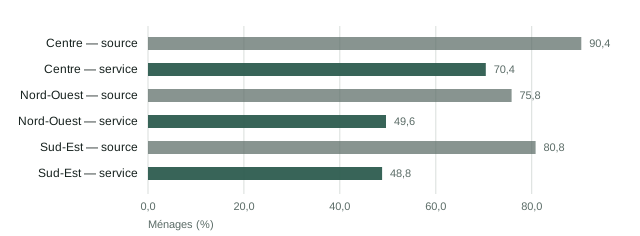
Source d'eau améliorée contre service de base, par district. Compter les sources surestime la couverture partout ; l'écart correspond aux ménages dont la source est améliorée et située à plus de trente minutes. Deux réglages par défaut qui changent un dénominateur
- Les clés de groupe manquantes sont écartées
Notes du présentateur
Les deux barres de chaque paire proviennent du mêmegroupby. La seule différence tient aux lignes que compte le numérateur — et elle déplace la réponse de vingt à trente points dans chaque district. Voilà ce que signifie en pratique « le dénominateur est tout l'enjeu ».Deux réglages par défaut qui changent un dénominateur — En Python
d = pd.DataFrame({"g": ["a", None, "a"], "v": [1, 2, 3]}) d.groupby("g")["v"].sum() # {'a': 4} d.groupby("g", dropna=False)["v"].sum() # {'a': 4, nan: 2}Deux réglages par défaut qui changent un dénominateur — En Python
assert muac["commune"].notna().all(), "des lignes sans commune seraient ecartees"Notes du présentateur
Par défaut,groupbyécarte les lignes dont la clé de groupe est manquante. Elles disparaissent du tableau et du total : les parties ne font plus le tout, et rien ne dit pourquoi. Dans ce secteur, la clé manquante est généralement la plus intéressante : une formation sanitaire sans district saisi, un ménage sans code de site, un enfant sans commune. Utilisezdropna=Falseet décidez délibérément, ou vérifiez que la clé est complète :Deux réglages par défaut qui changent un dénominateur
- Les catégories non observées réapparaissent en lignes vides
Notes du présentateur
Si la clé de groupe est catégorielle, le comportement par défaut est désormais de ne renvoyer que les catégories observées :Deux réglages par défaut qui changent un dénominateur — En Python
c = pd.DataFrame({"k": pd.Categorical(["x", "y"], categories=["x", "y", "z"]), "v": [1, 2]}) len(c.groupby("k", observed=True)["v"].sum()) # 2 len(c.groupby("k", observed=False)["v"].sum()) # 3 — inclut un "z" videDeux réglages par défaut qui changent un dénominateur
- Passez-le explicitement — Le comportement par défaut a changé d'une version de pandas à l'autre, et un script qui s'y…
Notes du présentateur
Les deux sont justes, pour des questions différentes. Rapporter sur les formations ayant transmis des données appelleobserved=True; rapporter la couverture face à une liste de formations qui auraient dû transmettre appelleobserved=False, car une formation à zéro ligne est justement le constat. Passez-le explicitement. Le comportement par défaut a changé d'une version de pandas à l'autre, et un script qui s'y fie produit un autre tableau sur la machine d'un collègue.Regrouper sur plusieurs clés — En Python
by_commune_month = ( muac.assign(month=muac["screening_date"].dt.to_period("M"), gam=gam) .groupby(["commune", "month"], observed=True) .agg(measured=("muac_mm", "count"), gam_cases=("gam", "sum")) )Regrouper sur plusieurs clés — En Python
by_commune_month.loc["Gonaives"]                      # une commune, tous les mois
by_commune_month.reset_index()                        # retour a des colonnes plates
Notes du présentateur
Le résultat porte un MultiIndex. Deux façons de travailler avec :Regrouper sur plusieurs clés — En Python
wide = by_commune_month["gam_cases"].unstack("month", fill_value=0)Notes du présentateur
reset_index()avant toute écriture en CSV, systématiquement — sinon les colonnes d'index disparaissent ou arrivent sans nom. Pour transformer le résultat long en tableau large attendu par un rapport :fill_value=0est sans risque ici, car une commune-mois sans cas en avait réellement zéro. Ce serait faux pour un taux, où l'absence signifie « non calculé » et non « zéro pour cent » — distinction à vérifier chaque fois que vous y recourez.transform : une statistique de groupe sur chaque ligne — En Python
muac["commune_mean"] = muac.groupby("commune")["muac_mm"].transform("mean")
muac["vs_commune"] = muac["muac_mm"] - muac["commune_mean"]
Notes du présentateur
aggréduit ;transformrenvoie une valeur par ligne d'origine. C'est ainsi qu'on compare une ligne à son propre groupe sans jointure : Utile pour signaler un site dont les mesures s'écartent systématiquement du reste — c'est exactement le contrôle qu'emploie le projet Analyse d'enquête SMART pour repérer une équipe mesurant 0,5 kg trop léger.apply, et pourquoi l'éviter — En Python
# Fonctionne, mais lent, et renvoie un objet dont la forme depend de la fonction.
muac.groupby("commune").apply(lambda g: g["muac_mm"].mean(), include_groups=False)
Notes du présentateur
applyexécute une fonction Python par groupe et constitue de loin l'opération la plus lente de pandas. C'est aussi la plus souple, donc celle vers laquelle on se tourne d'abord. Préférez une agrégation nommée. Réservezapplyaux opérations exigeant réellement le tableau du groupe entier — une régression par groupe, un classement par groupe avec égalités départagées sur une seconde colonne — et passezinclude_groups=False, désormais nécessaire pour éviter que les colonnes de regroupement ne soient transmises à votre fonction.Les tableaux croisés se lisent mieux dans un rapport — En Python
pd.crosstab(muac["commune"], muac["outcome"])

pd.crosstab(
    muac["commune"], muac["outcome"],
    values=muac["muac_mm"], aggfunc="mean",
).round(1)
Notes du présentateur
pivot_tableest ungroupbysuivi d'ununstack, avec une signature plus agréable :crosstabavecnormalize="index"donne les proportions par ligne, ce qu'un tableau de référencement doit généralement montrer. Gardez les effectifs à côté : un taux de référencement de 50 % sur quatre enfants n'est pas le même fait que 50 % sur quatre cents, et seul l'effectif les distingue.Écrire le résultat — En Python
OUTPUTS = PROJECT / "outputs" / "tables" OUTPUTS.mkdir(parents=True, exist_ok=True) by_commune.reset_index().to_csv(OUTPUTS / "gam_by_commune.csv", index=False)Écrire le résultat — En Python
definitions = pd.DataFrame([
    ("MAG", "PB < 125 mm ou oedemes bilateraux prenant le godet",
     "enfants avec une mesure de PB ou une evaluation d'oedemes saisie"),
], columns=["indicateur", "numerateur", "denominateur"])

definitions.to_csv(OUTPUTS / "definitions.csv", index=False)
Notes du présentateur
index=Falseaprèsreset_index()— sinon vous obtenez une colonne d'entiers sans nom que quelqu'un ouvrira plus tard dans Excel et utilisera pour trier. Pour un tableau destiné à être lu plutôt que calculé, écrivez la définition avec lui : Un nombre et sa définition voyagent ensemble, sinon la dispute mensuelle sur le dénominateur recommence.Ce qui vient ensuite
- Le tableau agrège correctement et les deux moitiés de chaque taux proviennent d'une seule opération.
Notes du présentateur
Le tableau agrège correctement et les deux moitiés de chaque taux proviennent d'une seule opération. L'unité suivante règle la dernière pièce — dates, âges et périodes de rapportage, où un âge en mois décide du standard de croissance applicable — puis enveloppe l'ensemble dans un script qui s'exécute sur la machine de quelqu'un d'autre.