Leçon 1 sur 8
Unité · La marque et la comparaison
La comparaison décide de la marque
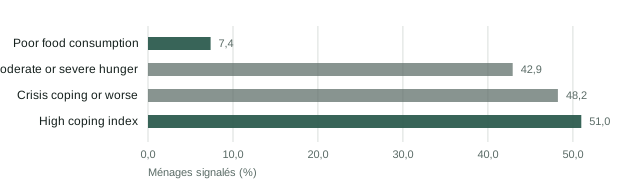
Quatre instruments de sécurité alimentaire sur les mêmes 1 955 ménages donnent 7,4 %, 42,9 %, 48,2 % et 51,0 %. Écrit en phrase, un lecteur acquiesce ; dessiné en quatre barres, personne ne passe à côté. Le type de graphique a été décidé par la comparaison, non par préférence.
Partez de la phrase, non de la bibliothèque
Avant tout code de tracé, écrivez la phrase que le graphique affirme. La marque en découle presque mécaniquement.
| Ce que la phrase compare | Marque | Pourquoi |
|---|---|---|
| Des catégories entre elles | Barres horizontales triées | La longueur est l’encodage le plus fidèlement lu, et les étiquettes tiennent |
| Une quantité dans le temps | Ligne | La pente est la comparaison ; un diagramme en barres des mois la cache |
| Une partie contre son tout | Une seule barre, ou le nombre | Un camembert, c’est deux nombres et une légende |
| Deux variables continues | Nuage de points | La position sur les deux axes |
| La même comparaison selon les lieux | Petits multiples | Une forme répétée, lue une fois |
| Où quelque chose s’arrête | Étapes ordonnées | La chute entre les barres est le constat |
Rien sur cette plateforme n’a encore eu besoin d’une marque hors de cette liste, ce qui est un fait sur les rapports de programme plutôt que sur la liste : les comparaisons qu’un programme fait sont massivement catégorielles, temporelles, ou une proportion assortie d’un intervalle.
Le graphique des quatre instruments
import pandas as pd
import matplotlib.pyplot as plt

prevalence = pd.Series({
    "Poor food consumption": 0.074,
    "Moderate or severe hunger": 0.429,
    "Crisis coping or worse": 0.482,
    "High coping index": 0.510,
})

fig, ax = plt.subplots(figsize=(7, 2.6))
ax.barh(prevalence.index, prevalence.values)
ax.invert_yaxis()                       # first row at the top
ax.set_xlabel("Households flagged (%)")library(ggplot2)
ggplot(prevalence, aes(x = share, y = reorder(instrument, share))) +
geom_col() +
labs(x = "Households flagged (%)", y = NULL)Horizontales, parce que les étiquettes sont des mots. « Faim modérée ou sévère » pivotée à 45 degrés sous une barre verticale est un graphique qui a décidé que ses propres étiquettes comptaient moins que ses barres.
Triées, sauf si l’ordre signifie quelque chose. L’ordre alphabétique est un ordre que personne n’a demandé. Ici l’ordre naturel est par valeur, et la version triée fait de l’écart d’un facteur sept la première chose vue.
Une exception à connaître. Quand les catégories ont leur propre ordre — phases IPC, bandes de PB, mois, niveaux scolaires —, trier par valeur détruit une information que le lecteur possède déjà. Triez par valeur, ou par l’ordre propre de la catégorie, et jamais par l’alphabet.
Le graphique qui est un tableau
coverage = pd.Series({"Measles first dose": 0.87, "Measles second dose": 0.61})# Two numbers. A chart of two numbers is a chart of nothing.Deux ou trois nombres ont leur place dans une phrase. « La couverture passe de 87 % à 61 % entre la première et la seconde dose » se lit plus vite que n’importe quel graphique, occupe une ligne, et ne peut pas être mal lu depuis le fond d’une salle.
Un graphique gagne sa place vers cinq catégories et cesse d’être lu vers vingt-cinq. En dessous de cinq, écrivez la phrase. Au-dessus de vingt-cinq, vous dessinez un tableau et devriez dessiner un tableau — ou agréger, ce qui est un constat plutôt qu’un choix de mise en forme.
Où quelque chose s’arrête
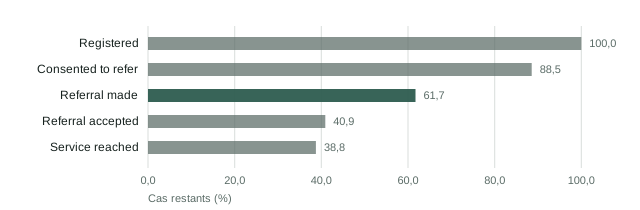
Une filière est une suite d’étapes, chacune sous-ensemble de la précédente, et la question utile est de savoir où se produit la plus grande perte.
stages = pd.Series({
    "Registered": 1.000, "Consented to refer": 0.885, "Referral made": 0.617,
    "Referral accepted": 0.409, "Service reached": 0.388,
})
losses = -stages.diff().dropna()
print(losses.round(3))
print(f"largest drop: {losses.idxmax()} ({losses.max():.1%})")
# The drop is the finding; the bars are how you show it.La plus forte chute vaut 26,8 points, entre le consentement et l’émission de l’orientation. Ni au service, ni à l’acceptation — au point où un travailleur social décide s’il oriente ou non.
Barres dans l’ordre des étapes, jamais triées. La séquence est le sens. Et la figure marque la plus forte chute, parce qu’un lecteur parcourant cinq barres décroissantes prendra sinon la dernière pour l’histoire.
Trois marques à éviter, et par quoi les remplacer
Le camembert. Les angles se lisent moins fidèlement que les longueurs, et un camembert de plus de trois parts a besoin d’une légende pour être lu du tout. Employez une barre triée. Le seul camembert défendable est une proportion unique contre son complément, et une phrase vaut encore mieux.
Le graphique à double axe. Deux séries sur deux échelles, et le point de croisement est décidé par l’endroit où vous placez les axes. Employez deux petits graphiques empilés, partageant un axe des abscisses, pour qu’un lecteur voie les deux sans qu’on lui affirme une relation que l’échelle a inventée.
Le quoi que ce soit en 3D. La profondeur n’ajoute aucune donnée et déforme chaque longueur qu’elle touche.
# The one line of matplotlib configuration this course insists on.
plt.rcParams.update({"axes.spines.top": False, "axes.spines.right": False})theme_set(theme_minimal(base_size = 11))La barre empilée, qui est parfois juste
L’empilement est le seul cas contesté, il vaut donc la peine d’être précis.
Les barres empilées sont lisibles pour le segment du bas et illisibles au-dessus. Chaque segment sauf le premier part d’une base différente, si bien que comparer le troisième segment d’une barre à l’autre revient à comparer des longueurs qui commencent nulle part en particulier.
Empilez quand le total compte et que la composition est secondaire — une charge de cas ventilée par catégorie, où la première question du lecteur est l’ampleur de la charge. Employez des barres groupées ou des petits multiples quand un composant précis est la question.
N’empilez jamais des pourcentages qui ne totalisent pas 100. Les quatre instruments ci-dessus se recouvrent : un ménage peut être signalé par trois d’entre eux. Les empiler dessinerait une barre de 149,5 % et impliquerait un tout que personne ne possède.
Rapportez-le en entier
Food security instruments, 1,955 households, 2024

  Four instruments were applied to the same households and are shown as a
  sorted horizontal bar chart. The bars are prevalences, not components of a
  total: households can be flagged by more than one instrument, so the bars
  do not sum and are not stacked.

  Poor food consumption            7.4%
  Moderate or severe hunger       42.9%
  Crisis coping or worse          48.2%
  High coping index               51.0%

  The chart's claim is the spread, not any single bar. 76.3% of households
  are flagged by at least one instrument and 3.4% by all four.
Le second paragraphe est celui qui empêche de mal lire le graphique, et il fait deux phrases. Un lecteur qui suppose que ces quatre barres sont les parties de quelque chose en construira une charge de cas.
La suite
Chaque barre de cette leçon est une proportion estimée sur un échantillon, et aucune ne porte d’intervalle. La leçon suivante les y met, et constate que l’ordre d’un graphique à douze communes n’y survit que dans trois cas.